


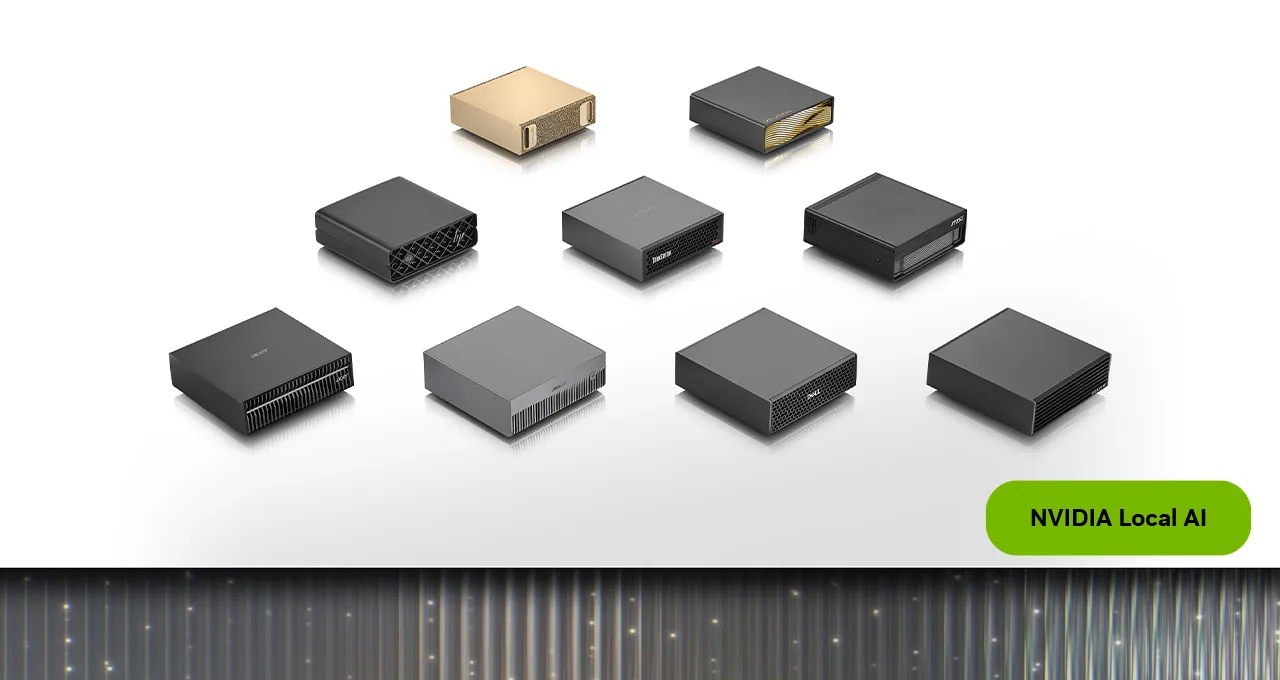
DGX Spark 64GBは、最大1000億パラメータのモデルを、クラウドに頼らず端末の中で動かす机上の計算機です。NVIDIAの発表では、Acerなど6社から10月23日に、$4,999からの価格で出ます。私は発表の原文を読み、128GBモデルと同じ所・違う所と、2台つないだときに伸びる数字を確かめました。
1. 64GBという、新しい入口
『アベンジャーズ/エイジ・オブ・ウルトロン』で、トニーは杖の宝石を解析させ、その構造を既存のプログラムへ適用させようとします。相手は、マーベルシリーズ、アイアンマン、アベンジャーズに登場する人工知能 AI(J.A.R.V.I.S.)です。作中でも密度が高すぎて、落とし込めませんでした。
現実でも、手元の機械で動かせるAIの規模は、積んでいるメモリで決まります。市販の最上位級GPUでも、搭載メモリは1枚24GBです。今回の発表は、64GBのユニファイドメモリを積んだ机上の1台です。
この1台で届くのは、手元の機械で動くAIに自分の資料を読ませ、自分用の受け答えをさせるところまでです。作中のような未知の構造の解析は、この範囲の外にあります。
01. 同じ中身で、メモリだけを選ぶ
新しい構成で変わるのは、ユニファイドメモリの量です。GB10 Grace Blackwell Superchip、DGX OS、NVIDIAのAIソフトウェアスタックは、128GBモデルと同じだとNVIDIAは明記しています。エージェント、推論、ファインチューニング、データサイエンス、エッジ開発を、同じ1台の中で続けられます。
02. 6社から、10月23日に
NVIDIA Agent Toolkit、CUDA-X AIライブラリ、Nemotronのオープンモデル、Ollama、vLLM、CUDA対応のPyTorchに、最初から対応しています。電源を入れてからモデルが動くまで数分だと書かれています。Blenderは、ビルド済みのインストーラを近日公開する予定です。
日本での販売条件は、公式発表では未公表です。作中の指示を現実の機器でどこまで再現できるかは、こちらにまとめています。
-

-
現実版J.A.R.V.I.S.の作り方2026 — Alexa+・HomePod・Geminiで家をAI化する
作中でトニーがJ.A.R.V.I.S.とF.R.I.D.A.Y.に出した指示を21件数え直し、2026年の市販品でどこまで届くかを1件ずつ突き合わせました。そのまま作れるのは7件です。
2. 2台で128GB。足せる前提で選ぶ
DGX Sparkには、ConnectX-7のNICが全機に標準で入っています。2台をQSFPケーブルで直結すると、メモリは128GBにまとめられ、対応するモデルの規模は最大2000億パラメータまで広がります。
01. ケーブル1本で、メモリが足し算になる
2台は200GbEで結ばれます。発表が挙げる「1台で足りなくなる場面」は、より大きいモデルを載せるとき、より長いコンテキストを扱うとき、複数のエージェントの要求を同時に受けるときの3つです。
02. 設定は Sync に任せる
月末にはSync Model Launcherも出ます。Qwen3.8 27Bをダウンロードして1台でも2台でも起動でき、手元のノートPCから使えるように設定されます。OpenCodeの設定も済むので、ブラウザでコードを書き始められます。
03. 1.7倍という数字の読み方
1.7倍は、Qwen3.8 27Bという特定のモデルでの比較値です。ほかのモデルでの値は、発表に書かれていません。1台で組んだワークフローは、ソフトウェアの環境を組み直さずに2台へ移せると説明されています。
3. 発表が挙げた3つの使い方と、ほかの選択肢
発表が挙げる使い方は3つです。どれも、手元で動かし続ける計算機が1台あることを前提にしています。
01. 24時間、動かし続けたい人へ
2つめの使い方では、モデルの推論をDGX Sparkが受け持ちます。手元のPCは、エージェントや制作アプリを動かすほうに使えます。
02. 急がなくていい人へ
Windows PCで使いたい人には、別の製品があります。RTX Sparkを搭載した新しいWindows PCが、今月、Acer、ASUS、Dell、HP、Lenovo、Microsoft、MSIから出る予定です。AlibabaのQwen-Image-2.1のような軽量なオープンウェイトのモデルは、RTX GPUでもローカルで動くと案内されています。
4. 10月23日、何を決めるか
決めることは2つです。1台で始めるか、最初から2台を前提にするか。そして、どのフレームワークで動かすかです。
01. まずは1台で始める
私なら、1台から始めます。2章で書いたとおり、2台目を足すときにソフトウェアの環境を組み直す必要がなく、1台で組んだワークフローがそのまま2台で動くと説明されているからです。$4,999からという価格は、クラウドのインスタンスを立てずに、自分のデータで試す場所を机に置く費用です。
02. 届く前にやっておくこと
build.nvidia.com/sparkのプレイブックのうち、vLLMでのLLM配信、ローカルLLMでのOpenClaw、複数台での分散ワークロードの3本は、64GB向けに近日対応とされています。
5. よくある質問
DGX Spark 64GBはいくら?
$4,999 からです。Acer、ASUS、Dell、Gigabyte、HP、MSI の6社から 10月23日(金)に出ます。64GB 構成はメーカーパートナー限定です。GB10 Grace Blackwell Superchip と DGX OS、NVIDIA の AI ソフトウェアスタックは 128GB モデルと同じとされています。
128GBモデルとの違いは?
違いはユニファイドメモリの量です。チップ、OS、ソフトウェアスタックは同じまま、価格を抑えた構成という位置づけです。64GB の1台で、最大1000億パラメータのモデルと、その上に載るエージェント型アプリケーションを端末内で動かせると案内されています。
2台つなぐと何が変わる?
メモリが 128GB にまとめられ、対応するモデル規模は最大2000億パラメータまで広がります。メモリ帯域は2倍、性能は NVIDIA の Qwen3.8 27B テストで最大1.7倍です。2台は QSFP ケーブルで直結し、200GbE で結ばれます。
クラスタ設定は難しい?
ConnectX-7 の NIC が全機に標準搭載で、NVIDIA Sync の Cluster Assistant が機器の検出、構成の検証、ネットワーク設定までを担います。追加のセットアップは不要とされ、どの機器も同じスタックなので、1台から2台へ移るときの再設定もありません。
どのツールが使える?
推論フレームワークは llama.cpp、Ollama、vLLM、LM Studio です。加えて NVIDIA Agent Toolkit、CUDA-X AI ライブラリ、Nemotron のオープンモデル、CUDA 対応 PyTorch に最初から対応しています。電源投入からモデル実行まで数分と案内されています。
画像生成もローカルでできる?
Alibaba の Qwen-Image-2.1 が、生成と編集を一つにまとめた軽量なオープンウェイトモデルとして、RTX GPU、DGX Spark、DGX Station でローカルに動くと案内されています。Blender は、ビルド済みインストーラを近日公開する予定です。
6. まとめ
DGX Spark 64GBは、最大1000億パラメータのモデルを端末の中で動かす机上の1台で、$4,999から、10月23日に出ます。作中で落とし込めなかった規模の話は、現実ではメモリの量の話です。今回の発表で、その量が1台で64GB、2台をケーブルでつなぐと128GBになります。届く日までに、フレームワークと動かすモデルを決めておきます。
- 発売日:10月23日(金)、6社のパートナーから
- 価格:$4,999 から。64GB構成はパートナー限定
- 単体の上限:最大1000億パラメータのモデルを端末内で
- 2台構成:メモリ128GB、最大2000億パラメータ
- 届く前に:フレームワークとローカルモデルを決める
7. 画像の出典
- ① NVIDIA 公式発表・表示の安定のため、私のサーバーから配信しています
出典:NVIDIA 公式発表「NVIDIA DGX Spark 64GB Gives Developers More Ways to Build and Scale Local AI」を、2026年10月13日に原文で確認しました。発表日は2026年10月2日です。1章の24GBは、NVIDIAのGeForce RTX 4090の製品ページの値です。