


DGX Spark 64GB が、個人の机をAIの実行環境に変えます。最大1000億パラメータのモデルを端末の中で動かす新構成が、主要メーカーから登場。クラウドのインスタンスを立てずに、自分のデータで試せる場所を持っておく。そういう選択肢が増えた、という発表です。
手元のPCでローカルLLMを動かそうとして、メモリの上限で諦めた夜があるなら、DGX Spark 64GB という新しい入口が今月できます。
KPEは発表資料を読み、何が128GBモデルと同じで、何が違うのか、2台つないだときに何がどれだけ伸びるのかを確かめました。
読み終えたとき、1台で始めるか2台を見据えるか、そして急いで買うべきか待つべきかを決められるはずです。
1. 64GBという、新しい入口
結論から書きます。DGX Spark 64GB は性能を削った廉価版ではなく、メモリの量だけを選び直せるようにした構成です。GB10 Grace Blackwell Superchip、DGX OS、NVIDIA の AI ソフトウェアスタックは 128GB モデルと同じまま。最大1000億パラメータのモデルと、その上に載るエージェントを、クラウドではなく机の上で動かす前提になっています。
01 同じ中身で、メモリだけを選ぶ
新構成で変わるのはユニファイドメモリの量です。チップは GB10 Grace Blackwell Superchip、OS は DGX OS、ソフトウェアスタックはフル構成。NVIDIA は 128GB モデルと同じと明記しています。安い方は別物、という心配をしなくていい。
動かせるのは最大1000億パラメータのモデルと、それを前提に作られたエージェント型のアプリケーション。すべて端末の上で、クラウドに依存せずに。自分のデータを、どこにも送らずに試せる場所が机に来るという話です。
Grace Blackwell の演算、ユニファイドメモリ、ConnectX-7 のネットワーク、CUDA で加速する AI スタックが一つの筐体に入ります。エージェント、推論、ファインチューニング、データサイエンス、エッジ開発。道具を取り替えずに同じ箱で続けられるのは、地味に大きい。
02 6社から、10月23日に
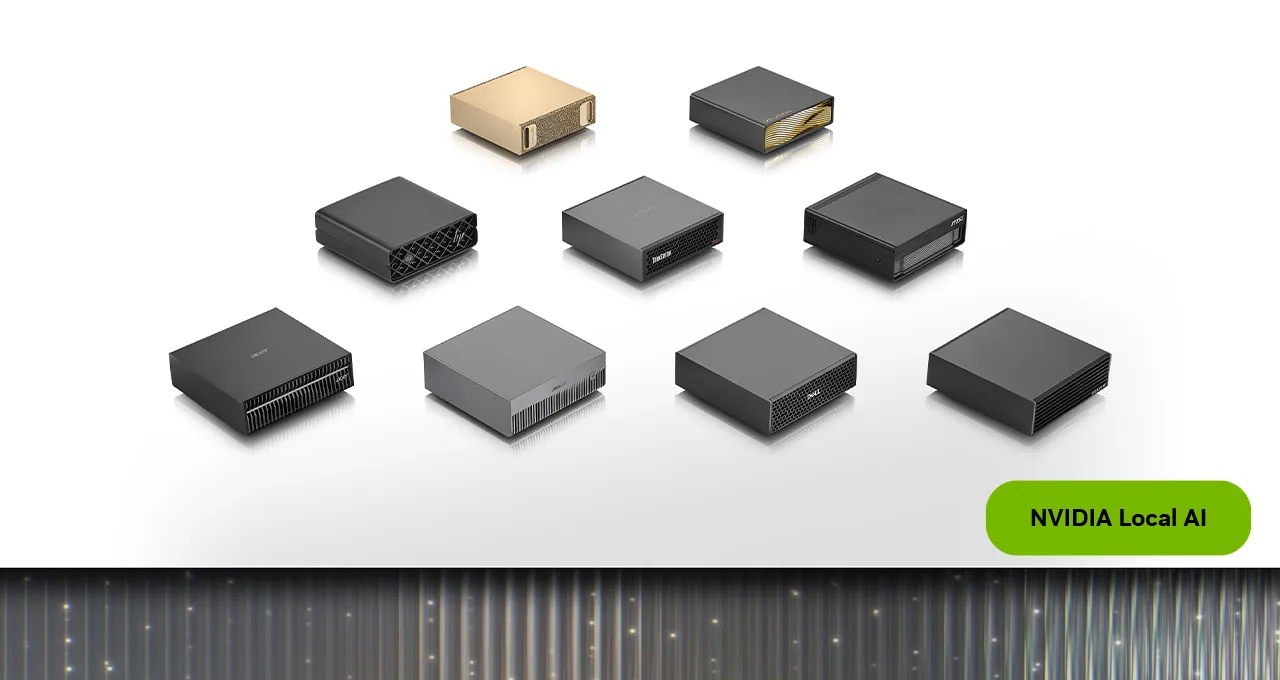
扱うのは Acer、ASUS、Dell、Gigabyte、HP、MSI。64GB 構成はメーカーパートナー限定で、価格は $4,999 から、発売は 10月23日(金)です。日本での販売条件は公式発表では未公表。
届いた日から使える、という設計も発表どおりです。NVIDIA Agent Toolkit、CUDA-X AI ライブラリ、Nemotron のオープンモデル、そして Ollama、vLLM、CUDA 対応 PyTorch が最初から対応。電源を入れてからモデルが動くまで数分と書かれています。Blender も早期対応組で、ビルド済みインストーラが近日公開予定です。
| 項目 | 発表内容 |
|---|---|
| 構成 | 64GB ユニファイドメモリ |
| チップ | GB10 Grace Blackwell Superchip |
| 単体の対応規模 | 最大1000億パラメータのモデル |
| 2台クラスタ | メモリ128GB/最大2000億パラメータ |
| 発売 | 10月23日(金) |
| 価格 | $4,999 から |
| 取り扱い | Acer・ASUS・Dell・Gigabyte・HP・MSI |
| 日本での価格 | 公式発表では未公表 |
2. 2台で128GB。足せる前提で選ぶ
買い足せる、というのがこの製品のもう一つの中心です。DGX Spark には ConnectX-7 の NIC が標準で入っていて、2台を QSFP ケーブルで直結すればメモリは 128GB にプールされ、対応するモデル規模は最大2000億パラメータまで広がります。メモリ帯域は2倍、性能は最大1.7倍。今日必要な分で始めて、あとから増やす。
01 ケーブル1本で、メモリが足し算になる
2台つないでもメモリが倍になるだけ、ではありません。200GbE のファブリックで結ばれた2台は帯域も2倍。NVIDIA の Qwen3.8 27B のテストでは、クラスタ構成の2台が1台に対して最大1.7倍という結果が示されています。
1台で足りなくなる理由は、だいたい三つに収まります。より大きいモデルを載せる、より長いコンテキストを扱う、複数のエージェントを同時に走らせる。どれもメモリと帯域で決まる話で、だからこそ足せるなら最初から全部を買わなくていい。

02 設定は Sync に任せる
クラスタの面倒は NVIDIA Sync が引き受けます。Cluster Assistant が接続された機器を検出し、構成を検証し、ConnectX-7 のネットワークを設定する。追加のセットアップは不要とされ、どのノードも同じソフトウェアスタックのまま。1台から2台へ移るときに作り直すものがない。
月末には Sync Model Launcher も来ます。Qwen3.8 27B をダウンロードして1台でもクラスタでも起動でき、手元のノートPCからアクセスできるように構成まで面倒を見る。OpenCode の設定も済ませてくれるので、ブラウザでそのまま書き始められます。
03 7倍という数字の読み方
この1.7倍は、特定のモデルでの比較値です。Qwen3.8 27B のテストで、クラスタ構成の64GB 2台が単体に対して示した値。ワークロードが要求する限り、まだ伸びる余地があるとも書かれています。数字そのものより、増やせる方向が用意されていることが要点です。
同じワークフローが、環境を組み直さずに1台から2台へ移る。スケールの話が引っ越しの話にならない。これは買うときの判断をずいぶん軽くします。
3. 向く人と、急がなくていい人
向いているのは、AI を使う人よりも、AI を置いておきたい人です。発表資料が挙げる使い方は三つ。エージェントを24時間動かし続ける、普段のPCのために推論を肩代わりさせる、仕事が育ったら2台に広げる。どれも、手元に常時動く計算機がある生活を前提にしています。
01 24時間、動かし続けたい人へ
コーディングや調査のエージェントを机の上で動かしっぱなしにする。コードをレビューさせ、資料を読ませ、何段階かの作業をやらせておく。クラスタにすれば、より大きいモデルや長いコンテキスト、同時に動く複数のエージェントの余裕が狙えます。
もう一つは、普段のPCを軽くする使い方。DGX Spark に言語モデルや画像生成モデルを置き、ノートやデスクトップではエージェントや制作アプリを触る。推論は箱が持つ。手元のPCは、他の仕事のために空く。
02 急がなくていい人へ
逆に、完成品のアシスタントがほしいだけなら、この箱は回り道です。対応フレームワークを落として、モデルを選んで、動かす。build.nvidia.com には NemoClaw、OpenClaw、Hermes Agent、OpenShell といったエージェント向けのプレイブックが用意されていますが、読んで手を動かす時間は要ります。
Windows PC で足りる人にも道はあります。RTX Spark 搭載の新しい Windows PC が今月、Acer、ASUS、Dell、HP、Lenovo、Microsoft、MSI から登場予定。Alibaba の Qwen-Image-2.1 のような軽量なオープンウェイトモデルは、RTX GPU でもローカルに動くと案内されています。
4. 10月23日、何を決めるか
決めることは二つだけです。1台で始めるか、最初から2台を見据えるか。そして、どのフレームワークで走り出すか。$4,999 からという価格は、クラウドのインスタンスを立てずに自分のデータで実験できる場所の値段として読むのが素直です。あとは、机の上にどれだけ任せたいか。
01 まずは1台で始める
正直に言って、ここは面白い。自分の部屋に最大1000億パラメータのモデルが載る箱が来て、しかも後から2台目で 128GB に伸ばせる。いま必要なメモリで買って、仕事が育ったらケーブルを足す。この順番が選べるのは、個人の机にはかなり効きます。
2台にしても環境を作り直さずに済む、という点も見逃せません。同じスタック、同じ手順。1台で書いたワークフローが、そのまま2台で走る。だったら最初の1台は、小さく始めていい。
02 届く前にやっておくこと
やることは三つ。llama.cpp、Ollama、vLLM、LM Studio のどれで走るかを決める。使いたいローカルモデルを選んでおく。2台構成を考えるなら、ConnectX-7 のポートをつなぐケーブルと Sync Cluster Assistant の手順を押さえておく。
build.nvidia.com/spark のプレイブックも見ておきたいところです。vLLM での LLM 配信、ローカル LLM での OpenClaw、複数台の分散ワークロードは、64GB 向けに近日対応とされています。箱が届く日までに、読んでおける資料はある。
5. よくある質問
DGX Spark 64GBはいくら?
$4,999 からです。Acer、ASUS、Dell、Gigabyte、HP、MSI の6社から 10月23日(金)に登場し、64GB 構成はメーカーパートナー限定。GB10 Grace Blackwell Superchip と DGX OS、NVIDIA の AI ソフトウェアスタックは 128GB モデルと同じとされています。
128GBモデルとの違いは?
違いはユニファイドメモリの量です。チップ、OS、ソフトウェアスタックは同じまま、価格を抑えた構成という位置づけ。64GB の1台で、最大1000億パラメータのモデルと、その上に載るエージェント型アプリケーションを端末内で動かせると案内されています。
2台つなぐと何が変わる?
メモリが 128GB にプールされ、対応するモデル規模は最大2000億パラメータまで広がります。メモリ帯域は2倍、性能は NVIDIA の Qwen3.8 27B テストで最大1.7倍。2台は QSFP ケーブルで直結し、200GbE のファブリックで結ばれます。
クラスタ設定は難しい?
ConnectX-7 の NIC が全機に標準搭載で、NVIDIA Sync の Cluster Assistant が機器の検出、構成の検証、ネットワーク設定までを担います。追加のセットアップは不要とされ、どのノードも同じスタックなので、1台から2台へ移るときの再設定もありません。
どのツールが使える?
推論フレームワークは llama.cpp、Ollama、vLLM、LM Studio。加えて NVIDIA Agent Toolkit、CUDA-X AI ライブラリ、Nemotron のオープンモデル、CUDA 対応 PyTorch が最初から対応しています。電源投入からモデル実行まで数分と案内されています。
画像生成もローカルでできる?
Alibaba の Qwen-Image-2.1 が、生成と編集を一つにまとめた軽量なオープンウェイトモデルとして、RTX GPU、DGX Spark、DGX Station でローカルに動くと案内されています。Blender もビルド済みインストーラが近日公開予定の早期対応組です。
6. まとめ
この発表が差し出しているのは、速さの数字ではなく置き場所の話です。$4,999 から、10月23日。最大1000億パラメータのモデルが机の上で回り、足りなくなればケーブル1本で 128GB になる。借り続ける前提から、持っておく前提へ。機能が増えたのではなく、AI を使う順番が変わります。自分の部屋に J.A.R.V.I.S. を置きたい人にとって、入口の高さが少し下がった。そういう一日になりそうです。
- 発売日:10月23日(金)、6社のパートナーから
- 価格:$4,999 から。64GB構成はパートナー限定
- 単体の上限:最大1000億パラメータのモデルを端末内で
- 2台構成:メモリ128GB、最大2000億パラメータ
- 届く前に:フレームワークとローカルモデルを決める
7. 画像の出典
- ① NVIDIA 公式発表・表示の安定のため当サイトのサーバーで配信